反向海淘系统最脏的输入:把用户粘贴的分享文案、淘口令、短链统一解析成商品 ID
反向海淘系统里,用户不会规规矩矩给你一条干净的详情页链接。他粘过来的可能是一整段带 emoji 的分享文案、一个 ¥xxxx¥ 淘口令、一段 m.tb.cn 短链,或者一条被跟踪参数污染到 200 字符的 URL。这篇讲我怎么把这件事做成一个稳定服务——解析链路、正则、短链展开、口令接口、缓存,以及把失败率从 12% 压到 1.5% 的全过程。
一、先盘点你实际要处理的输入长什么样
我在生产环境里捞了 500 条真实用户输入,粗分类如下:
这五类输入的解析成本完全不同。所以第一件事不是写正则,而是先做形态判定,再分派给对应的解析器。
二、解析链路的五段设计
我把它拆成五段,每段只负责一件事,任何一段失败都能定位:
原始文本
  → ① 文本清洗(去 emoji / 去全角 / 统一换行)
  → ② 平台与形态判定(1688 / 淘宝 / 京东 / 未知)
  → ③ ID 抽取(正则)
  → ④ 兜底:短链展开 / 口令解析
  → ⑤ 统一输出 goods_id + platform
① 文本清洗
看起来最没技术含量,实际是最容易漏的。用户从 iOS 复制过来的文案里有:
- 全角字符::? 以及全角数字 123
- 零宽字符(U+200B / U+FEFF):肉眼看不见,但会把你的正则切断
- emoji 与装饰符:✨🛒 之类
- 换行不统一:\r\n / \r / \n 混用
import re, unicodedata

INVISIBLE = re.compile(r"[\u200b-\u200f\ufeff\u2060]")

def clean(text: str) -> str:
    text = INVISIBLE.sub("", text)
    text = "".join("\r" if c == "\n" else c for c in text.split("\r")[0:1]) + text
    text = text.replace("\r\n", "\n").replace("\r", "\n")
    text = unicodedata.normalize("NFKC", text)     # 全角转半角,一步搞定
    return text.strip()
unicodedata.normalize("NFKC", ...) 这一行值一百行手写替换代码,它能同时处理全角字母数字和兼容字符,强烈建议放在清洗链最前面。
② 平台判定
不要只靠域名判断——用户可能只粘了"【淘宝】"这样的前缀词。我的判定顺序是:显式域名 > 文本前缀词 > 兜底未知。
PLATFORM_RULES = [
    ("1688",  r"(?:detail\.)?1688\.com|阿里巴巴|1688"),
    ("taobao", r"(?:item\.)?taobao\.com|m\.tb\.cn|天猫|淘宝|tmall"),
    ("jd",    r"(?:item\.)?jd\.com|3\.cn|京东|jd\.hk"),
]

def detect_platform(text):
    for name, pat in PLATFORM_RULES:
        if re.search(pat, text, re.I):
            return name
    return "unknown"
③ ID 抽取
三个平台的商品 ID 藏在完全不同的位置,这是最容易写错的一段:
ID_PATTERNS = {
    "1688":   r"offer/(\d{8,})",
    "taobao": r"[?&](?:id|itemId)=(\d{8,})",
    "jd":     r"(?:item\.jd\.com/|/product/)(\d{6,})",
}

def extract_id(platform, text):
    m = re.search(ID_PATTERNS[platform], text)
    return m.group(1) if m else None
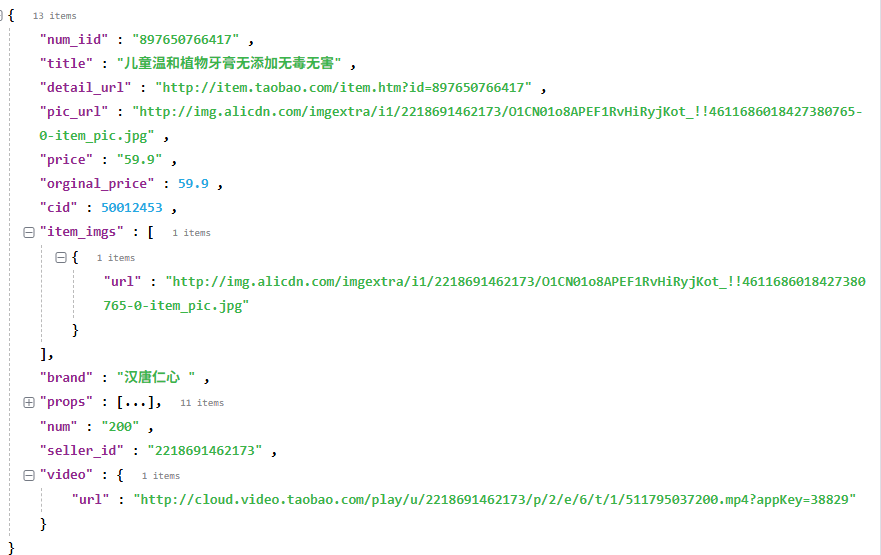
注意 1688 有个坑:detail.1688.com/offer/1234567890.html 里的 ID 是报价 ID,而 item_get 接受的 num_iid 就是它,不用做转换;但淘宝的 num_iid 和 sku_id 是两套东西,链接里带的是 num_iid。千万别把京东的 sku_id 当成淘宝的 num_iid 传进同一个字段,我在早期版本把两者混用,导致一整个类目的详情全查不到。
④ 短链展开
短链没有 ID,只能先跟重定向。这里有两个必须做对的地方:
第一,用手机 UA。 同一个 m.tb.cn 链接,桌面 UA 请求可能被重定向到一个带登录引导的中间页,Location 里没有商品 ID;手机 UA 通常会直接落到 item.taobao.com/item.htm?id=...。
第二,限制跳转次数并检查落点。 有的短链会先跳到活动落地页,再跳详情页,一次 HEAD 拿不到最终地址。
import requests

MOBILE_UA = ("Mozilla/5.0 (iPhone; CPU iPhone OS 17_0 like Mac OS X) "
             "AppleWebKit/605.1.15 (KHTML, like Gecko) Version/17.0 Mobile/15E148 Safari/604.1")

def expand_short(url, max_hop=5):
    for _ in range(max_hop):
        r = requests.head(url, allow_redirects=False,
                          headers={"User-Agent": MOBILE_UA}, timeout=8)
        loc = r.headers.get("Location")
        if not loc:
            return url
        url = requests.compat.urljoin(url, loc)
        if re.search(r"item\.(taobao|jd)\.com|detail\.1688\.com", url):
            return url
return url短链展开的实测成功率并不高——3.cn 这类会有一定的跳转异常,所以我把展开失败的情况统一转入口令/链接转换接口。
⑤ 淘口令与链接转换
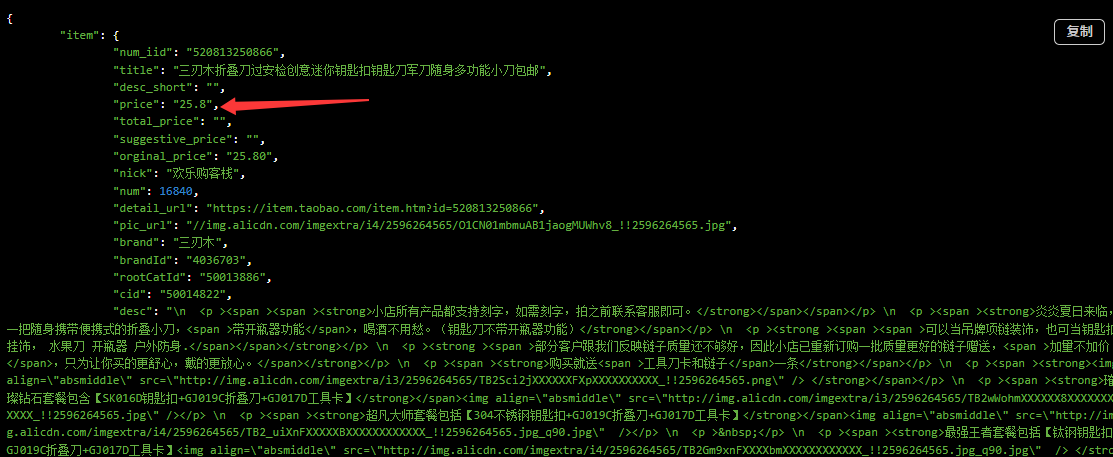
淘口令(¥xxxxxxxx¥)必须靠专用接口,正则解析不出来。淘宝平台的 item_password 后台统计成功率 95%,用来解口令是够用的;链接清洗与长短链互转用 item_link,它的成功率是 100%,是我这套链路里最稳的一环,我把它当"URL 归一化器"用——不管用户给的是淘客链、短链还是带一堆跟踪参数的长链,都先过一遍它。
def parse_password(text):
    url = "https://api-gw.onebound.cn/taobao/item_password"
    params = {
        "key": KEY, "secret": SECRET, "api_name": "item_password",
        "content": text,            # 直接传原始文案,接口自己找口令
        "result_type": "json",
    }
    r = requests.get(url, params=params, timeout=12).json()
    if r.get("code") != "0000":
        return None, r.get("code")
    return r.get("item", {}).get("num_iid"), "0000"

def normalize_link(link):
    url = "https://api-gw.onebound.cn/taobao/item_link"
    params = {"key": KEY, "secret": SECRET, "api_name": "item_link",
              "url": link, "result_type": "json"}
    return requests.get(url, params=params, timeout=12).json()
把口令和链接都归到 num_iid 之后,后面的详情、比价、加购链路就只需要面对一种入参。
三、四个花了两天才定位的坑
坑 1:& 被二次转义。 用户从浏览器复制来的链接里 & 可能已经是 &,你直接塞进 params 字典,requests 会把它再编码一次,服务端拿到的 id 值就带上了尾巴。做法是解析前先做一次 html.unescape。
坑 2:淘口令有生命周期。 口令并不永久有效,过期后接口会返回业务失败。我给口令结果单独打了短 TTL(10 分钟)缓存,过期即失效,不做长缓存,避免用户拿到已失效的 ID。
坑 3:短链落到 landing page。 有些短链的落点是活动页,页面上有几十个商品链接。我的原则是只接受能唯一确定商品 ID 的落点,出现多个候选就判失败、转人工——选错商品的成本远高于多一次人工。
坑 4:cache 在这里要慎用。 解析类请求(item_link / item_password)我全部关掉缓存(cache=no),因为同一个短链在不同时间可能指向不同活动页;而详情接口(item_get)走缓存没问题。混用缓存策略是我早期最隐蔽的成本浪费来源。
四、落地成服务:缓存与指标
把上面的逻辑包成一个 POST /resolve 接口,入参是原始文本,出参是 {platform, goods_id, source},source 标记它是从正则、短链还是口令拿到的。
关键是在缓存层做一层 raw_text → goods_id 的映射,因为同一段分享文案会被多个客服/多个用户反复粘贴:
def resolve(raw, ttl=7 * 24 * 3600):
    key = "rsv:" + hashlib.md5(raw.encode()).hexdigest()
    if cached := redis.get(key):
        return json.loads(cached)
    result = do_resolve(raw)                     # 五段链路
    if result["goods_id"]:
        redis.setex(key, ttl, json.dumps(result))
    return result
上线前后我记录了一组数据,解析失败率从 12.3% 降到 1.5%。下降主要由三块贡献:NFKC 归一化解决了一批全角/零宽字符导致的"看起来有链接、其实抽不出 ID";item_link 接管了脏链接清洗;缓存把重复粘贴的解析请求从下游接口上摘掉了——命中率稳定在 60% 以上,也就是说超过一半的解析请求根本不到达网关层。
监控上我只看两个指标:按 source 分的解析成功率、未知平台的原始文本采样。后者尤其有用——unknown 占比突然上升,通常意味着某个平台改了分享文案模板,比等接口大面积报错要早发现半天。
解析完成后,拿到 num_iid / sku_id 就该走详情了。这里提醒一句选型:1688 的 item_get(99%)可以放心做主链路;淘宝的 item_get 后台统计只有 40%,必须配降级;京东详情用 item_get_pro(78%),并且 不要碰它的 item_search(28%)。选错入口,前面解析做得再漂亮也没用。
五、写在最后
这套链路的价值在于:把不确定性收在入口处,让下游永远只面对一种干净的入参。 解析这件事没有巧劲,就是把清洗、判定、抽取、兜底、缓存五段各自做扎实,然后盯着指标慢慢补边界。